ASC24 结束的那一天,我其实心情是很舒畅的,倒不是说比赛的结果如何,而是想到自己也算是完整地参加了两届 ASC 比赛,认清了自己与头部高校同学的差距,也从中学习到了不止是知识、能力、技巧,更重要的是,ASC 算是让我自己找到计算机体系结构的“感觉”,并且我很高兴选择了这一充满困难和挑战,却又让我着迷的领域作为自己的研究方向。
按理说故事应该戛然而止,然后就是本科毕业、读博士…从此与 ASC 再无交集。直到在高级计算机体系结构课程上有一天沈老师神情凝重地叫住我,希望我协助指导 26 年的学生超算系列活动。我当时还吃了一惊,因为我知道实际上 26 年的团队还是基本比较确定了,而且我对队员安排也感觉比较有信心。队员中有程景愉、于晓两位老队员参加 ASC,还有黄熙涵作为队长组织 ISC,选出的同学也基本都是知根知底的,像姜澜、张宵瑜的新训班长就是咱们以前的老队员,刘畅参加过一次 ISC,邓愚智是程景愉的同专业好朋友,张涵是保研选手,程浩博、亓涵玉和何嘉烨是我们发掘的低年级学员。计算机类、拔河班、钱班、AIBD 班都有学员参与。
说实话,从本科开始,可能是受到张老师耳濡目染的影响,我对教学就非常感兴趣;从这个角度来讲,从参赛队员到协助指导的角色转变让我感觉会很有意思。另外,和熟悉的同学们一起能够在赛场上继续挑战系统极限,也是我愿意承担的工作。因此,我很愉快地接受了沈老师的邀请。
整个秋季学期我们都保持了比较频繁的交互,每周大约我和沈老师都会去一次三号院,我们还组织了一次邀请现在已经保研到清华大学的胡玉和在北京大学直博的邓湘云(两位 ASC22-23赛季的老队员)为我们做了一次分享。我们主要是为本科低年级的同学提供了若干学习材料,主要涵盖计算机系统的理解和运维。但我们很快发现,在大语言模型横行的今天,大家习惯性地遇到问题首先向大语言模型询问,或者将运维工作大量交付给大语言模型智能体来完成。我们完全理解和支持广泛使用大语言模型和智能体,所以没有强行要求参赛队员完全熟练掌握命令行的一切。一个有意思的场面就是,在我参加 ASC 的赛季,大家都还是精通 Linux 运维的选手,可以在命令行中像电影里的黑客一样凭空变出一切,而现在,大家的命令行接口却变成了与 Claude Code 或者 Codex 这样的编程智能体交互的输入框。
AI 还是太好用了。ASC 初赛的题目是 Embodied World Model,一个由宇树科技研发的世界模 型,以及 AMSS-NKCU,一个由台湾成功大学科研人员研发的引力波数值模拟程序。在几乎无限量的 Claude 4.6 和 GPT-5.5 xhigh 供应的条件下,我们的队员都能很快定位到全部瓶颈。 Agent 能够直接帮助我们运行程序、插桩完成性能分析、揭示程序的耗时分别集中在哪些函 数。对于 AMSS-NKCU 这样使用 Fortran 编写的程序,为了后续优化的方便,我们将热点函数直接使用了 C 语言重写,从而更好使用 OpenMP。ASC 初赛还是一如既往地黑盒,因为每个队伍的硬件资源条件不同、基线结果也不同,再加上风格各异的优化方向和优化思路、各个队伍间虚虚实实的进度交流,我们沿用了多年来提交初赛技术报告的一贯做法:完整地理解应用程序和我们所拥有的软硬件系统,分析其在我们所使用的平台上的性能瓶颈、提出优化方法、测试以说明方法的有效性——典型的面向体系结构的软件优化。初赛阶段,对于 Embodied World Model,我们通过混合精度、复用 GPU 上的 K/V 缓存、跨阶段视频数据复用和面向目标体系结构的机器学习编译器优化,得到了 5.27 倍的加速比。对于 AMSS-NKCU,我们在 Intel VTune 提供的结果上,通过将其链接到 Intel MKL、手工向量化、优化访存顺序、重写 MPI 通信,还添加了我们手写的基于 eBPF 的定制化线程调度器,加上 PGO 编译优化,最终得到了 28.77 倍的加速比。除此以外,我们还探索了 CUDA 实现,将核心函数移植到 CUDA 上。由于初赛阶段给出的测试用例较小,最终 GPU 版本得到了 7 倍的加速比。三号院 306 六楼和七楼的机器一直没有准备好,InfiniBand 交换机的速率只有 56Gbps,所以 HPL 和 HPCG 的结果一直没法跑出来。在距离初赛截止只有一周的时候,我在 vast.ai 上找到了一台 8 卡 A100 的服务器,在上面跑完了 HPL(134.7TFLOPS)和 HPCG(2.221TFLOPS)的结果,也算是由东西可以交了。
初赛平平无奇,但是根据我们的认识,初赛的结果很大程度上不取决于加速比,而是取决于参赛队伍解决问题的方法是不是足够新颖。我们采用的完全是标准的软件优化思路,发现瓶颈-优化瓶颈-得到加速。在组委会统计初赛结果后给出的新闻稿上,我们发现复旦大学队伍将这样一个科学计算应用实现为了一个张量计算问题(并不是 AI 模型,而是将物理模型算法实现为了张量计算),于是可以直接使用 PyTorch 等现代张量加速库。根据了解到的结果,我们决定 AMSS-NKCU 继续推进 GPU 版本,并针对每种可能的计算路径分别进行 GPU 移植。决赛新增了两个应用。QiboTN 是一个量子电路模拟的应用,且只允许在 CPU 上运行;LeWorldModel是由图灵奖得主杨立昆最新发布的世界模型,且只允许在 AMD Radeon W7900D Pro GPU 上运行。经过考虑,我们决定安排于晓完成 QiboTN 任务,由大一学生亓涵玉独立推进 LeWorldModel。五一期间我们在三号院 306-607 工作了完整的五天,为比赛做最后的准备。
对于 ASC 竞赛来说,很多设定到了现场之前我们都一无所知。QiboTN 是一个仍在快速迭代的软件,并且官方维护的版本主要针对 CUDA 后端进行优化,CPU 为后端的代码很多地方都是 TODO。在 ASC 的线上题目介绍视频中,组委会还提到了 MPS MPI 实现存在巨大精度问题(10^2量级)。我们发现,MPS 在计算的时候,需要维护一个全局规范中心,在 MPI 的实现下,当 qubit 数量增加,不同的 MPI 进程会维护多个全局规范中心(但不一定是真正的中心),因 此导致了误差。在 GPT-5.5 xhigh 的帮助下,我们使用了一种全新的方法,在不影响并行性的 情况下,放弃了对全局规范中心的需要,规避了误差来源,提高了 MPS 方法的弱可扩展性,实现了 MPS 向又快又准的跨越。我认为这是一个重要的算法创新。AMSS-NKCU 应用我们也成功实现了所有计算路径到 GPU 的移植,并且保证了计算结果与 CPU 端的一致性。在没有 LLM和 Agent 的时代,这几乎是不可能在短短几个月之间由单人完成的任务。我们尽量通过各种渠道保障了 Claude、Gemini 和 GPT 最新模型的无限量 Token 供应,调试好设备,准备好各种脚本和工具,编写了详细的计划和文档,准备好迎接决赛的到来。
说实话,我对集群运维还是轻车熟路的。装机的第 1 天,我们很快就完成了机器的部署。跟我们预想的一样,InfiniBand 果然炸了。按照我们的预案,我开始调试 InfiniBand,驱动是好的, opensm 也起起来了,但是居然是物理链路有问题。真相大白,组委会提供的 4 条线只有 2 根能用。景愉去找组委会拿到了新的线,然后开始调试各个应用。第一天的机时安排还是出了一些问题,每个应用都想跑,但是都在边跑边调,所以没有完全按照计划。今年的 CPU 还从 Intel 换到了 AMD,EYPC 9755 CPU 使用的是 Chiplet 架构,每 8 个物理核心被安排在一个 CCD上,并且 AMD CPU 体系结构还具有某些神秘的优化(例如,在我们的经典体系结构教材中介绍的某些访存模式对处理器不友好,在 Intel CPU 上确实可以观察到性能下降,但是 AMD CPU上却几乎不会受到影响,不清楚 AMD 有些什么黑科技),不论是在 BIOS 中调整 CPU 的某些选项,还是软件侧调整缓存和核心绑定的配置,都让我们有点捉摸不透。为了降低基础功耗,我们先将 BIOS 从“自定义”调整为了“平衡”,然后重新开机。这个时候,我们发现 CPU 版本的 HPL 跑不起来了,总是提示核心数没有正确被绑定。借助 LLM,熙涵开始排查是 mpirun 的哪个参数指定错误了,或者是 Intel OneAPI 的 mpirun 存在某些特定的实现导致了错误。最经过半个小时的紧张排查,在熙涵无心执行了一下 lscpu 命令后,我们突然发现,每个节点上双 CPU 的 256 核神奇地变为了 224 核,丢失了 32 个核!我突然意识到,这就是每个 CCD 上丢失了一个核。我小慌了一下,因为我不记得“自定义”模式到底需要改些什么才能滚回去了。这个时候,我想起来好像关闭了 IOMMU 会导致某些核丢失,然后立刻明白,平衡模式关闭了 IOMMU,于是每个 CCD 内会有 1 个核去承担 MMU 的作用。但是现在没有办法回到先前的“自定义”模式了,所以我飞快地重置了 BIOS,自己给出了新的配置,禁用了不必要的 CPU 选项和 I/O 端口,还对 CPU 某些行为做了一些微调,最终回到了我熟悉的场景,将四台服务器核一台 InfiniBand 交换机的静息功耗从 2400 瓦降低到 1180 瓦。
这个时候机器就跑起来了。开完一个小会之后,我们分配了接下来三小时的机时,简单微调了 HPL 和 HPCG,确保脚本和环境变量保持稳定,在正赛开始时可以随时运行。装机的第一天晚上,我们进行了 ISC 的第一次预答辩,两个比赛连轴转让我有点感到压力了。
装机的第二天,我们针对现场集群存在的一些新问题,以 hack 的方式抓到了服务器 BMC 的 API,然后在 Agent 的帮助下完成了风扇控制脚本。起初,我们是通过网页端控制服务器的 BMC,但我们发现,即使我们在网页端将服务器风扇固定为某个转速,服务器似乎依然会智能地调整风扇,而不是完全遵循我们的设置。Agent 帮助我们完成了一个每 5 秒钟向 BMC 发送 一个风扇调整请求的脚本,以轮询的方式固定了风扇的转速。紧接着,我们发现 AMD 的 CCD架构决定了不能像 Intel CPU 那样固定关闭某些核心,或者将不同核心设定为不同的性能模式。观察到这一点后,我们现场 tune 了一个可配置的功耗管理器,在运行不同题目时,可以动态 调整到特定的性能模式,以 CPU 的 TDP 为基准,当 CPU 撞到我们设定的功耗墙时,会自动减低频率以回到安全功耗区间。团队赛应用 ICON 方面,我们很快扫描了一遍运行时并行参数配置,找到了我们认为的最优解。
装机方面我们一直处在系统稳定性、可靠性、功耗控制的前列,并且从 4 台服务器上机架到安装完所有软件包、依赖库和应用程序所花费的时间不超过 1 小时。这是我们一直以来的优势,积累了大量的经验,即使是遇到 ASC24 上组委会提供了新款服务器,多数队伍完全无法控制功耗,以及这次 CPU 从 Intel 换到 AMD 上,并且包含了 AMD CPU、AMD GPU 和 NVIDIA GPU 三种资源异构的架构下,我们仍然能够快速完成系统搭建。同时间,大多数队伍都或多或少被卡在了某些方面。我们的系统运维也得到了组委会的肯定,正赛第一天刚开始比赛就得到了组委会颁发的可靠集群奖。装机第二天,大家都严格按照了规定的机时进行调试,一切都显得较为顺利。ISC 队伍也在下午到教室继续打磨了线上报告。
于是就来到了正赛第一天。我和景愉场内场外电话连线,很快完成了 HPL 结果。由于我们只 有 4 张 A100,我们也没有对 HPL 和 HPCG 抱太大希望。8:30,我们完成了 HPL 的测试,然后开始运行 HPCG。在另外两台没有 A100 GPU 的机器上,我们开始调试 ICON。很快,半小时 后,HPCG 也运行结束,于是开始运行 Embodied World Model。神奇的事情发生了,我们有优化后的 Embodied World Model 在决赛测试用例上无法通过正确性验证!我们当即决定退回到基线版本,然后发现基线版本竟然也无法通过正确性验证!明显我能感受到我们的场内场外的同学都开始慌了。10:50,我们将官方提供的参考运行指南移植到了我们的机器上,并修复了 bug,终于启动了 ICON。好在尽管这个测试用例是规模最大的,但是我们前一天参数扫描时猜中了这个测试用例,因此我们对这个测试用例运行的时间估计非常准确。熙涵把邓愚智叫出场来,一起调试 Embodied World Model。经过一个小时的调试,终于发现有一个配置是错误的。在我们的复盘中,我们发现,按照组委会给定的指导手册,只应该修改某个配置,但是几乎所有的 LLM 都会将这个配置与另一个配置绑定在一起,认为其是同一个配置;在使用 Agent 时,会将两处一并修改,而多修改的那一处将直接导致结果精度无法满足要求。由于调试 ICON 和 Embodied World Model 花费的时间大大超过预期,我们当日的机时计划完全被打乱。等待 ICON 在 13:30 运行完毕时,Embodied World Model 仍旧没有调试出来。这个时候我们发现 ICON 的第 2 个测试用例又存在 bug,又需要现场调试,于是又现场继续改代码。在这个过程 中,我已经有点着急了,尤其是看到队员将运行日志扔进 Claude Code 的对话框中,然后就看着 Claude Code 开始读取代码、执行命令、开始各种排查…我越看越着急。我发现在这个过程中我们的队员明显慌张了,大脑似乎宕机了一般,智能行尸走肉地把遇到的问题粘贴给 Agent,然后 Agent 开始漫长地响应。Embodied World Model 终于在 14 点调试出来,然后我们花费大约 40 分钟时间跑完了基线代码。这个时候 ICON 仍然在调试当中,突然之间,我们发 现所有的 CPU 都拉起来了,定睛一看才发现 Claude Code 排查出了错误,把应用跑起来了。
这个时候其实应该立即停掉 ICON,查看 Claude Code 具体执行了什么命令的,然后自己重跑。但是我们并没有这么做。正如前文所说,我们负责这个题目的队员已经完全无法思考了,也不清楚 Claude Code 在后台配置了些什么,不能确定杀掉这个测试用例之后还能不能重新跑起来。这个时候我发现我们的队员已经完全依赖于 Agent 了,在准备赛题时,Agent 还写了一个帮助 我们通过运行日志查看 ICON 进度,但是第 2 个 case 不清楚是 Claude Code 如何运行起来的, 查看进度的脚本没有输出,我们的队员就束手无策了。我在旁边干着急,我说,你直接 tail 日志文件,watch -n 5 刷新呀,队员这才反应过来。其实回头想,有好几个环节,我们都应该停 下来。不清楚 Claude Code 怎么跑起来的题目,应该停下来。跑起来了之后查看进度的脚本没 有输出了,应该停下来。但我们都没有信邪,抱着侥幸心理,跑了一个半小时,最后发现没有通过正确性验证。然后就更乱了阵脚。Embodied World Model 这边,熙涵和邓愚智调试一头雾水,代码版本太混乱了,使得我们的“拼好帧”方案完全无法工作。就这样陷入了无休止的调试 中。这个时候我们听说北京大学的 ICON 模型只需要 30 分钟就能跑完最小的测试用例,我们 立刻开始跑,但是我们的进度条却告诉我们要 7 个小时!情况危机,我们开始手忙脚乱地调整并行参数,终于在下午 5 点的时候降低到 144 分钟,但时间已经完全来不及了。就这样, Embodied World Model 也最终没有调试出来能过正确性验证的版本。在一片紧张与混乱之中,第一天的比赛一下子结束了。
第一天结束后我感觉大家似乎都有一点低落。我也高度紧张。比赛结束后,大家几乎都没有胃口吃饭,在场外的观众席上就开始了今天的例会。例会总结了今天的经验教训,然后安排了第二天的机时。
第二天相对顺利。AMSS-NKCU 最终只需要使用到 1 种计算路径,而这种计算路径是我们前期已经完全移植到 GPU 上了的。第一个测试用例中我们花费 170 秒完成了测试(基线代码超过 20 分钟),然后火速跑完了剩下两个测试用例。紧接着,LeWorldModel 跑完了基线代码拿到了结果正确分数。然后我们现场开始考虑其他优化,实现了早停,最终将运行时间降低到 150 秒(基线代码大约 30 分钟)。最大的挑战在于 QiboTN。QiboTN 在决赛现场给定了一份全新的代码,是组委会特定的某个版本,并强制要求使用某种后端。好在我们还是成功运行了起来,并且替换了后端计算库,运行完了所有测试用例。这个时候,我们发现有一个问题就是答案具体是多少我们不知道,我们只知道我们跟浙江大学的结果完全一样,上海大学跟台湾大学完全一样,但是跟我们不一样。我们的场内同学又慌张了,坚持希望重跑这个测试用例,并且还在答题卡上写下了两个答案(导致组委会当晚检查答案时给我们打电话问我们为什么另一个答案只提供了答案没有提供运行的日志)…然后,我们又听说北京邮电大学只需要 10 几秒就能够完成我们 1 个半小时的任务,因为他们删除了量子电路模拟中的电路构造部分(占用了 99.9% 的时间),但是惊讶地发现不会影响最终结果。
我们认为这个结果是不可接受的,并且向组委会反映了情况,但是组委会没有采纳。第二天下午结束后我们去打印了海报,然后进行了 ISC 线上答辩的最后一次预演。
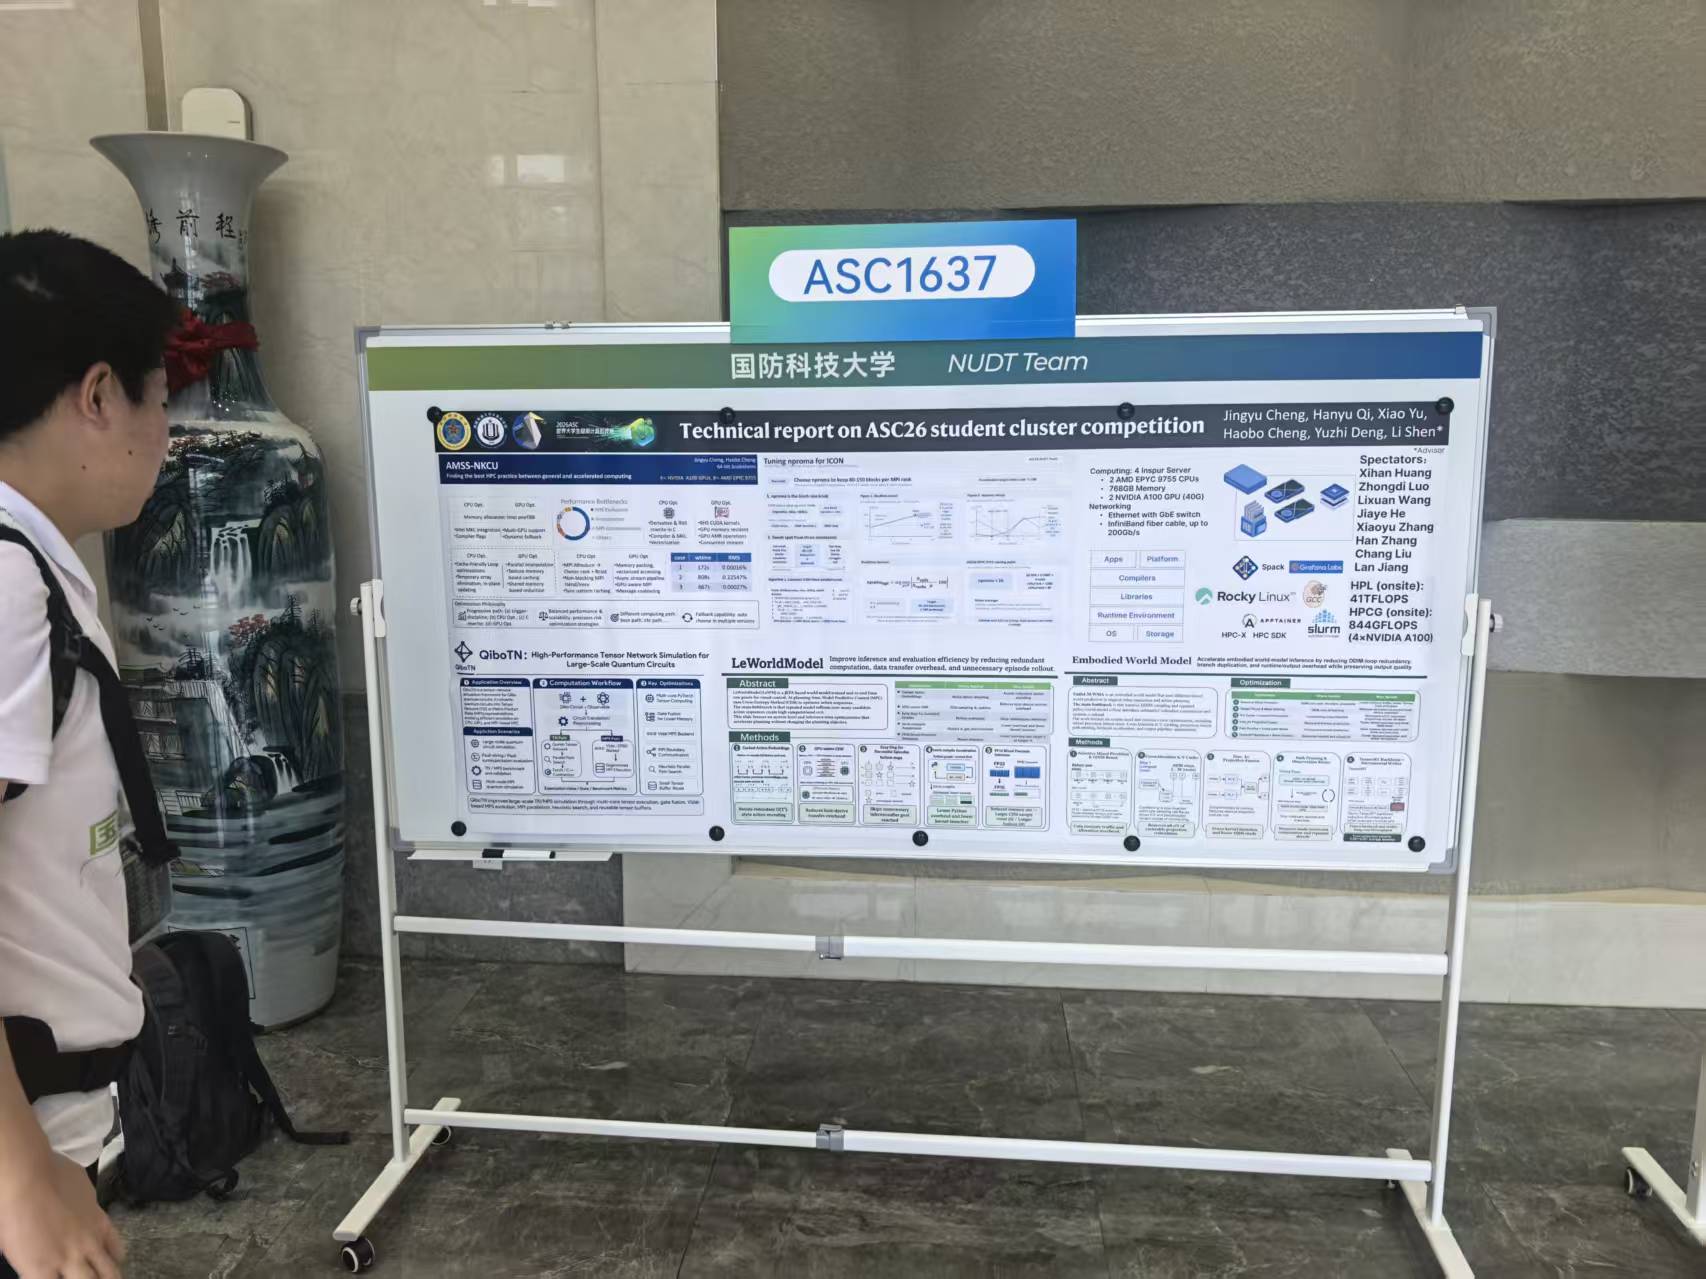
海报交流阶段,出乎我们的意料,我们的海报竟然得到了第二名,根据熙涵的说法,Torsten Hoefler 教授甚至给我们打出了满分。遗憾的是,最终我们只得到了第 10 名。主要的问题可能是,现在每一个题目都有超高加速比出现,另外,竞赛和在超算中心真正实际运行程序可能还是有一些差别,限时竞赛更关注的是如何在规定的时间内得到符合要求的结果,而我们很多时候还是没有关注竞赛性。看得出来大家还是很努力了,但是其实每年都有一些遗憾,或许我们还是没有跟上世界的变化,所以每一年都在踩新的坑,而跟上了变化和趋势的学校就能很好适应。
如何与 LLM Agent 协同工作也是新的问题,Agent 能够极大增强单兵能力,从宏观的角度,我们当然可以泛泛而谈,说什么机器都是辅助、工具都是参考,必须人要能够拍板。这种观点是很容易输出的。但关键问题在于,我们应该如何约束 Agent,以及在极度紧张的时间压力下,还能够保持清醒的头脑,而非把自己完全托付给 Agent。从这次 ASC 可以看出,首先,不同于 ACM/ICPC 等程序设计竞赛,以及 CTF 等规则明确、有标准答案的比赛,ASC 暂时还无法被 LLM 和 Agent 完全替代(而程序设计竞赛和 CTF 比赛中人类已经无法胜过 AI 了),其次,同样都是用世界上最先进的 AI,为什么有的学校就能表现更为出色,也是值得思考的问题。AI所欠却的,其实是对特定软硬件系统的整体理解,而这恰恰是软件优化的核心;而我们的人脑,通常被认为拥有足够长的上下文,所以能够做出更合理的决策。所以,不论怎么样,队员的基本功还是需要受到重视,同时一定要激发队员主动探索出各种天马行空的想法。基本功是想法的基础,而想法除了基本功的加持外,更重要的视野和学科思想的指引。我也是学院培养的本科生,就我的感受而言,客观地评价,目前本科的培养模式很难培养出这样的学生。我觉得,很多学生其实能力并不差,也很努力,地方大学的有些学生并不是有着咱们这样的苦行学习生活的,但是由于资源、由于视野,出路却很好。以拔河班建设来说,给我的感受就是没有人实际地关心过,搞了太多务虚的内容,而真正能够落地的东西却很少。我记得我本科入学报道的那天,毛晓光老师对我说,在这里学习生活可能会让你感觉到束缚,一切都被按在确定的轨道上前进,但是思想一定不能盲从。拔河班(包括计算机类)招进来了一批其实高考成绩还很好的学生,但是出路却不是很好;那些高考分数差不多的同龄人,考入了地方大学,却能找到一份不错的工作,或者更容易去到更好的高校深造。我给 24、25 级地方计算机类的学弟学妹们都担任了《大学计算(下)》的教辅,每次只要出标准的题目,大家就总能考很高的分,一旦出一些略有变化的试题,大家就无所适从。我认为这跟我们在 ASC 赛场上遇到突发状况就束手无策是一样的,大家的视野和思维都太过局限,这让我想到我在本科的时候,也去出公差听过学校的各种优秀学员报告会,但我总感觉大家好像很难把目光往三号院外瞥一眼。
现在在回长沙的火车上,总感觉自己好像又本科毕业了一次。坦诚地说,一直受到了学院的各种关心爱护,我也希望学院能够越来越好,但是,我始终觉得,如果再不对学生的培养方式进行激进的改革,可能真的要落后时代了。