ASC24给我最大的体验是:在赛场上总有猝不及防的变化。这和ASC22-23的感受是完全不同的(可能是前一年太摆了,按部就班地做就完事了,没有别的想法)。也是因为ASC22-23上的成绩过于难看,所以想着今年能不能在能力范围内多做一点事情。
装机、HPL、HPCG和团队赛
今年用的服务器是Inspur 5280M7,实际上在网上也搜不到这个型号的手册,只找到了5280G7的,在群里听巨佬们说可以相互替代,所以就一直读的这个手册。
手册自然是写得很奇怪的,说的是M7支持4张双宽GPU,还幻想了很久可以通过一机四卡的方式部署二机八卡的构型。4月8日晚上到上海以后,制定的策略就是我来沿着最经典的四机八卡的路子装机,反正是跑脚本,跑完就完事;另外几位队员研究怎么把四张卡挂到一台机器上。
Day -2
今年的位置是按着超级团队赛排的,所以我们跟北京大学、山西大学、双鸭山大学大和FAU在一起。北大今年也想搞一机三卡,孙同学还提醒我可以用上电源上方的位置,但是要防止GPU被烧了。机架上准备了了6台机器,于是我们就拆下来了最下面的一台做改装实验。
其实我们的技术路线定的很早,八点入场之后,我们就直接把最下面的服务器拆了下来,这次比赛提供的新服务器和我们在学校集群所用到的服务器区别还是挺大的,决定好了魔改最下面这个,我们就给它取名225(和家里的最后模拟所用到的节点一个ip号),首先决定尝试的是一机四卡。
经过四处寻觅,最后在隔壁山西大学(most popular)那里借过来一盒工具,然后对服务器开始拆卸,从一开始GPU cage的拆卸就和学校里的不太一样,一个弹簧旋钮卡在那里,下面固定着主板无法拆除,解决这个问题把卡槽卸下来看到里面的Riser板的时候,我们是很兴奋的,我们发现Riser上可以插三个PCIe的金手指,这显然是满足了我们最开始想要插双卡的幻想。
最下面那个(0口)不认识是干嘛的,手册上也没细说,不管;中间的那个(1口)本来就是用来正常插GPU的,挺好;我们盯着上面的插槽(2口)看了一会儿,觉得可以把第3张卡插到这个槽里面,而且还真的插上了,当时我们都觉得有戏。由于另外一张卡的。另外一个Riser上就只有两个PCIe插槽了,但是有一个需要用来接InfiniBand,所以就只能装一张GPU。检查了一下,机箱里也没有再留更多的接口来插PCIe口,于是决定装一机三卡。
一个卡槽由单卡变为要塞下双卡,而且还是我们带的双宽GPU,空间需求的问题无疑体现出来了,最直接的瓶颈体现在了上面讲到的弹簧旋钮下面的卡桩和后面以太网口等的固定限高,这使得两张双宽的GPU就没有了“生存空间”,尤其是那个卡桩的高度太高了,会直接抵住GPU的下端,金手指直接就插不进去,悬在外面…而且双卡的高度会超过这个GPU cage的容纳限度,装不下两张卡。
不过也没多大事儿,那就拆咯,全拆,下面的卡桩拆了,GPU cage也给他拆了只留下我们需要的Riser板,服务器外机上的一些不相关的槽都给它拆了,然后两张GPU就可以妥妥的插进这块板,对应的金手指也能够顺利的连接上主板,后面的以太网口等端口肯定是固定的没办法动,上面的限高就会超,不过不盖上外面的盖子也不是什么大事。最后有模有样的一机三卡“架构”也就设想改装出来了。
到中午的时候,我们基本上把第一台设备改造完了,我和余骑继续改装,剩下的同学去吃饭,想着一会儿他们来换我们。我是准备上电从BMC里面看看有几张卡被检测到。然后就很熟练地进入BIOS,把BMC的管理口配置好静态IP,保存,开机后发现BMC设置的地址居然还是没有任何变化。由于时间也还算是比较有限,所以想着那还是把这台机器的操作系统给装上,然后lspci看一下有多少张卡被检测到。
然后不出意外地,只检测到了两张卡。我们最开始以为是电源问题,或者说PCIe的金手指没插好,又关了机器重插了一遍,发现还是没有任何作用。摸了一下插在2口上的GPU,感觉还是有一点温度的,和另外两张卡的温度甚至比较接近。但是三张卡被布设在一个很狭小的空间里,完全是紧挨着的,所以不确定是从其他GPU传过来的温度,还是说自己发热产生的温度。但是我们猜想应该是2口上的GPU没有被检测到。为了验证这件事,我们甚至把0口和1口的GPU卸下来,只插2口的GPU,再开机检测了一遍。很好,果然检测不到任何显卡。这个时候我们首先想到的是可能我们的魔改有问题,还是请工程师来看一眼,所以跳到主席台去找组委会的工程师。
得知工程师去吃饭了,我们也就去休息室迅速吃了个饭。
过了一会儿,工程师来了。先来的工程师也跟我们最初一样进BIOS一阵捣鼓,修改BMC静态地址、保存、退出,一气呵成,然后遇到了同样的问题,只要一退出BIOS,配置的BMC静态地址就掉了。工程师同志又一阵捣鼓,试图用DHCP的方式拿到BMC的IP,不出意外,也是退出BIOS之后就掉。然后...他就很尴尬地走了。过了一会儿,第二个工程师来了,来看我们的三卡改装方案。他拿着Riser仔细端详了一会儿,告诉我们:2口这个金手指是个摆设,PCB板上没给它连线:)。当时除了无语还是无语。没办法,迅速跟指导老师汇报了个情况,然后果断开始调试四机八卡的系统。
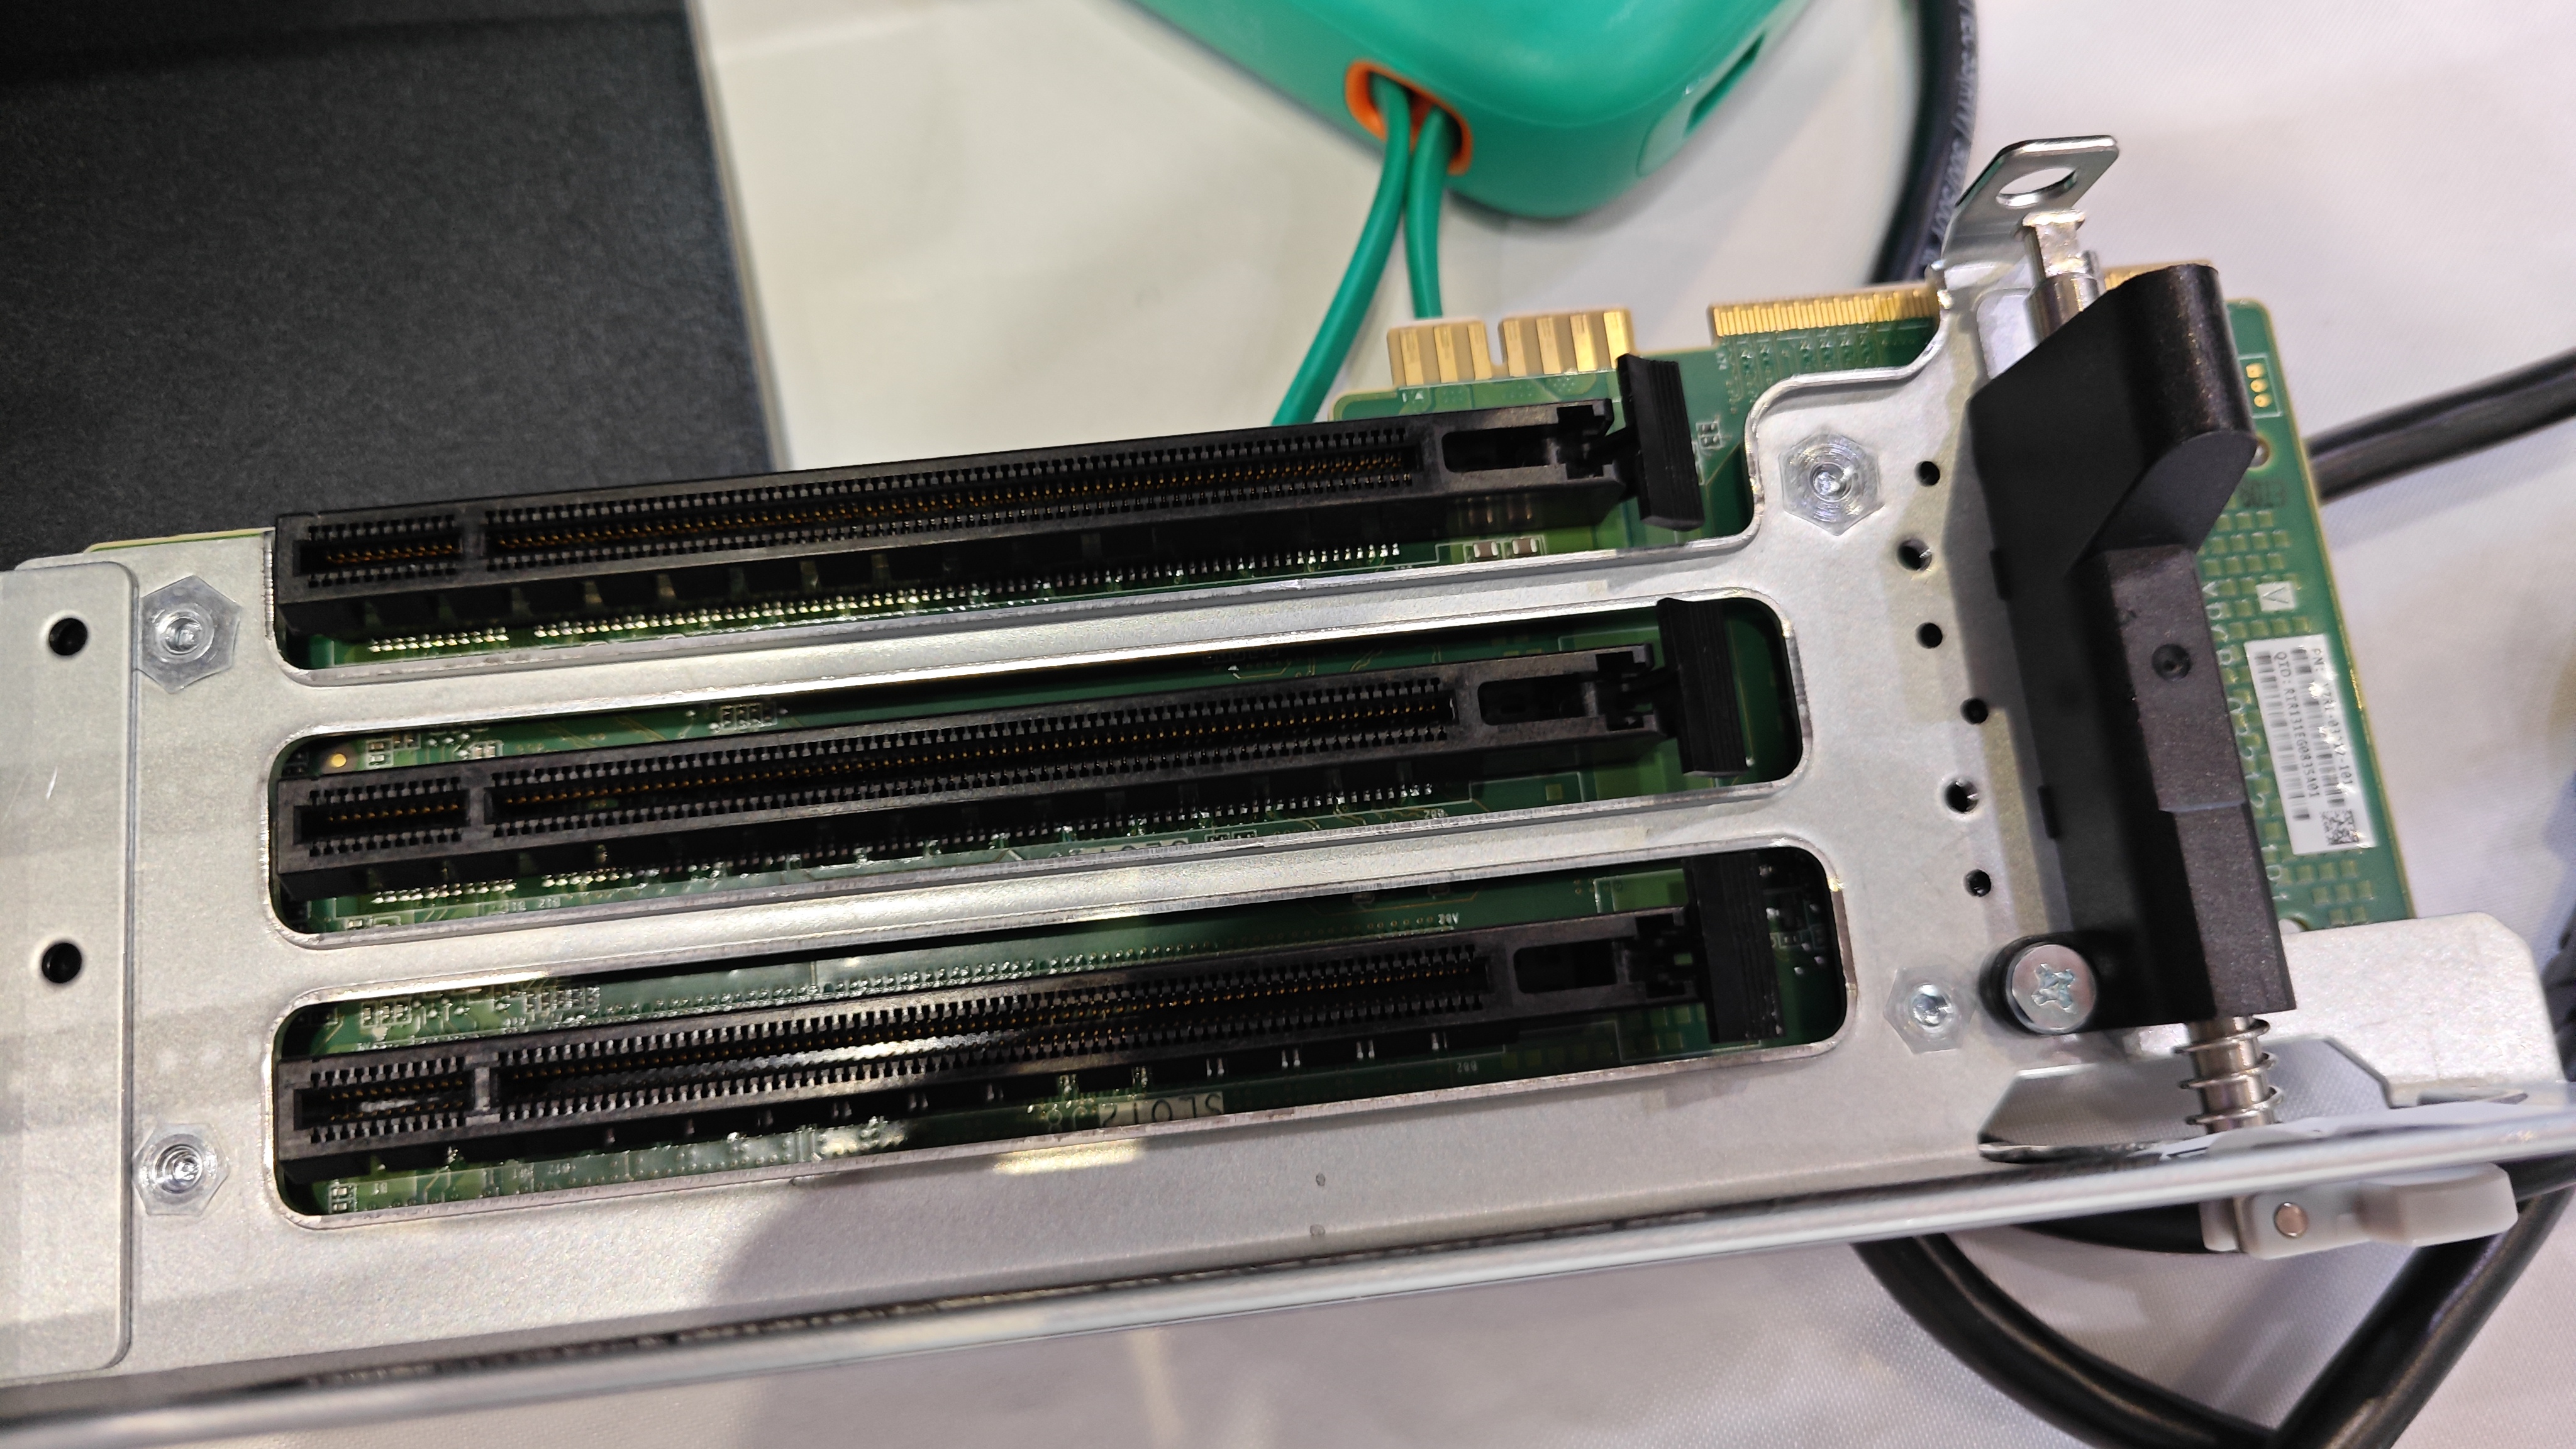
毫无用处的2号口,正如这张图片一样是一个摆设
为了控制功耗,我们最开始想的就是先把内存条给拆了,拆到只剩128GB。因为单根内存条是32GB的,所以我们就按照手册的指示插了4跟内存条。
开机。系统自检过程变得异常漫长,大概得花10分钟才能进入系统。最开始我还以为是拆内存条之后机器检测到硬件改动,第一次启动需要比较长的时间,于是重启了一下,发现还是需要这么长的时间。更要命的是,进入系统之后发现系统只检测得到64GB的内存。我们又开始怀疑我们是不是内存条没插好,对照手册又检查了一遍,发现并没有任何问题,内存条也都是插好了的,但就是只检测得到64GB内存。
见鬼。我们想着,既然剩下两根内存条都没什么用,那不如也拆了。于是我们又按照手册把内存条减少到只有2根,也就是64GB,开机,还是很慢很慢,半天进不了系统。
但是这个时候时间已经非常紧张了,我们几乎是以流水线的形式在进行软硬件的安装、调试和测试。到晚上六点的时候,我们决定放下硬件的改动,开始跑HPL。震惊的是,HPL跑不起来,我又重新检查了一遍运行的脚本,发现没有改掉HPC-Benchmarks容器里面的一个绑核的bug,有点见鬼,又重新改了回来,终于跑上了。(后来第一天也遇到了类似的问题,推测原因可能是NFS time skew导致的)
跑的结果很好,比我以前任何一次都要好,91TFlops。但是因为我们实际上没限功耗,跑到一半的时候,PDU突然跳闸了😅。
关于这个跳闸,就不得不吐槽两句了,其实我们的功耗峰值,在跑HPL的时候也就4kw左右,这还处在调试阶段,虽然显示屏通红警告,但是莫名其妙的跳闸归0还是有点子离谱在里面的,比我们更嚣张的队伍也大有人在,不少队伍警报着顶着5kw+的功耗跑完HPL相安无事,结果我们这里才刚刚往上跳,还是功耗的启动上升阶段,就给寄掉了,直接清0…
鸭大看见我们跳闸了,感觉遇到了难兄难弟一样,说他们也跳了,而且文件系统还寄了。又花了四十分钟修复了问题,这个时候已经晚上七点四十五了。
装机的第一天,我们实际上浪费了一半的时间来摸硬件,甚至还没来得及开始调BIOS。Gomars和CAE也分别遇到了点环境上的问题,一直没有装上,大家一度都比较紧张。晚饭也没来得及吃。
在最后的20分钟,我们决定把内存条重新插回去。说干就干,我们赶在断电前插回去了两台机器。拖着耗着在整个场馆几乎最后时刻被驱逐出场。
Day -1
装机第二天的策略是早上把Gomars和CAE全部装好,下午调试,晚上六点开始HPL调参。
进入赛场,第一件事情就是迅速把剩下两台服务器的内存给重新插进去,同时几个应用进行安装。
CAE从十一点半开始测试,我们把所有的核心和GPU都分给了CAE,发现一个很神奇的事情,和在学校机器上的结果相比,CAE运行的总时间变长了,但是计入成绩的有效时间变短了。在这个时候我也通过DHCP把机器的BMC连上了,发现上面有关于主板的电源策略设置,我们的是Custom。顺手调了一个Powersave,然后重跑了一遍CAE,发现功耗没有任何变化...调到Performance模式也如此。
这个时候其他学校的学生也在线上或者线下吐槽今年的机器了,组委会跑到我们这边来看了一眼,上海大学的DHCP服务器给我们分配的IP是10.254.133.143/27。除了被改装过3卡的机器没办法登进去BMC,剩下的机器都可以进,所以我们打算退机器的时候退掉那台。其实刚开始机器没办法设置IP我们是很慌的,在BMC里面调整了半天,退出、保存、重启之后看到的还是0.0.0.0,这里我们摸索了大半个小时,甚至去把浪潮的工作人员请过来,操作了半天也同样无果,给我们提供了一个相对麻烦的路线就走了…不过这天上午总体上很顺利,Gomars甚至在4台机器上都能顺利运行起来了,比在学校机器上平均快5到6倍。但是危机总是隐藏在看似顺利的进展中。我、余骑、熙涵、景愉到展板后面去把之前改装的3卡的机器重新恢复成2卡,回来之后,我们惊讶地发现,Gomars就是不能在4台机器上并行运行了。我们开始排查错误,发现是222节点炸了,余骑开始尝试修复222节点上的Gomars。同时我们还发现CAE在机器上运行的速度变得贼慢,况且CAE跑一步可能需要很多时间,我们完全无法判断是卡住了还是出现了其他的问题。为了给Gomars和CAE多一点调试时间,我们甚至等到六点半才开始调HPL控功耗。
不出意外,功耗压不住。NF5280M7和去年用过的NF5280M5在逻辑上不太相同,M5是在workload起来之后会按照预先设定的功耗来跑,只需要把GPU功耗压住就行,M7会持续给主板送大电流,但是因为我们限定了GPU的功耗,就导致功耗根本分不到GPU这边。完蛋了,这个时候已经七点了,我们迅速用6卡跑了一个结果,63TFlops,想到赛前还跟鸭大的队员讨论6卡的事情,他们说6卡跑个90TFlops就行,这差别也太大了。后来才知道鸭大在BIOS上做了很多fine-tuning,剩下来了300W多的功耗。但是那个时候已经没有时间去调了,M7的BIOS和M5的术语也不是很像,我打开之后甚至连术语都不知道是什么含义(后来也有很多队伍吐槽,有的队伍甚至连关闭超线程都没找到),所以在装机第一天的时候就把我认识的能调的部分都调了。那个时候我的心态是有一点崩的,而且Gomars始终不能在4个节点上并行,烦躁的心情让人难以忍受。
我又继续把风扇拉到最低,把CPU的核心关闭到只剩8个,想起之前在NF5280G7的手册上看到过可以关闭处理器的某些特定单元,想着把AVX512给关了,而且又不能在BIOS里面关,因为正赛第二天的科学计算应用需要,而在正赛中是不能重启机器的。然后就在BMC里面慢慢找,发现M7的BMC功能比M5少了好多,取而代之的是我们感觉没什么用的功能,比如有很多传感器监测机器的温度分布什么的。(当然,对于生产环境来说,机器的稳定性肯定是第一位的,这种情况下这些机制是必要的。但是对于跑分的比赛来说,感觉意义不一定有那么大,反而还有额外的功耗开销)
超340瓦左右。七点四十五,我们决定再退一台机器,我去找组委会,余骑、熙涵和景愉拆机器,最后在晚上七点五十五成功退掉了机器。最后我们决定就用3机6卡。
第二天晚上回酒店的情绪是很失落的。给我的感觉是没什么好跑的了,肯定比不过,没有一点悬念。
Day 0
正赛第一天,计划是九点之前提交HPL。进场后我们立刻开机,然后把风扇拉到最低。组委会来提醒,由于上海大学网络系统问题,不能将网线直接插在交换机上,必须只能单条插在某一台节点上,然后使用DHCP。还好在前一天我们就发现了NF5280M7存在的BMC bug,如果配置静态IP就可能会掉,所以我们直接切了备用方案:221、222每个节点上接2根线,一根用来BMC,一根连交换机;220上接3根线,一根连互联网,一根连BMC,一根连交换机。用Day -1的参数跑了一遍,居然奇迹般地从63TFlops变到了73TFlops。简直是奇迹。这个时候山西大学(狠狠爱了,全场最耿直的队伍)过来给我们说他们也是70多,我问是70多得多还是70出头,答复说是70多得多。看得出来他们的队员也是挺焦急的,跟指导老师远程电话调参。我们继续调。7次的结果分别如下表所示
| 1 | 2 | 3 | 4 | 5 | 6 | 7 |
| 73.336 | 75.152 | 77.677 | 71.8 | 78.833 | 77.87 | 75.84 |
余骑管着交换机的风扇,熙涵管着220和221的风扇,景愉管着222的风扇。我负责读取系统和GPU的温度,决定什么时候跑。九点钟,山西大学提交了他们的HPL结果,80出头,所以我们也觉得我们应该能达到类似的成绩。所以我们继续调参,准备再调半小时。最终结果是没有超过78.8TFlops,后来得知是山西大学使用了80G的A100,可以把N拉到更大的规模。我们超过172000就CUDA Out of Memory了。实际上可能各个卡的体质略有不同,N拉到17600时,只有220节点上的一张卡OOM,其他卡都还可以再往上拉,所以可能也跟卡本身的体质有关系。HPL今年算是非常奇葩了,三机六卡都不用压除了风扇以外的功耗,简单关掉CPU1,把所有进程绑到CPU0上,居然还有100W的功耗用不完。
我们是九点半提交的HPL结果,然后领到LLM inference和Paraseis。不出所料,LLM inference是要将我们自己的框架merge到ASC提供的进行MMLU测评的框架上,但是ASC官方提供的不是量化到4bit的模型。山西大学跑去问了问,说是用自己量化好的模型或者别人量化好的模型也是可以的。
简单评估了一下,感觉LLM inference可能有一点代码量在身上的,所以先飞速把Paraseis给装好了。官方提供的工具死活不能识别我的GPTQ量化的版本,网上查了huggingface的文档,说的是GPTQ已经被merge到了新版本的transformers里面,应该是直接就能用的。然后就开始各种玄学操作,什么把.safetensors重命名,然后复制.bin文件变成pytorch_model.bin,试了一堆莫名其妙的办法,总之框架就是不认。
然后上海大学的队员就跑过来问我们BMC咋回事,我们解释了一番,于是上海大学的队长就冲到组委会这边要求换机器。组委会拒绝。双方甚至争执起来。上海大学队长一怒之下直接走了,剩下的队员一脸懵。同时组委会又带着一帮人来到我们的旁边,听说是有队伍举报北大作弊。但是当时完全没吃上瓜,毕竟我们还没跑HPCG,都是中午吃饭的时候看了一眼群聊天记录才知道有这么两个大瓜。
这个时候已经十一点半了,准备先挂一个HPCG,然后去吃饭。HPC Benchmarks的HPL和HPCG优化是越来越烂了(可能是对A100来说越来越烂了),今年跑的是23.3的版本,甚至不敢用24.3。设置的1800秒但是跑到最后居然用了2200秒(第一眼其实看成了2200GFlops,笑了)。
然后猜想可能是GPTQ还是有玄学问题。hack进lm_evaluate的源码,发现GPTQ估计是没戏了,之前甚至删掉gptq-xxx.safetensors和gptq-xxx.bin,然后把之前的gptq-xxx.bin重命名成pytorch_model.bin。把后端也替换成了魔改之后的vllm,在220上准备使用awq。
很好,后台已经起起来了一个进程,把模型从硬盘读进内存。ASC提供的框架居然只能单进程读取模型,读一次半小时。读完之后就卡住了。咱也不敢动,GPU利用率又是0%,不知道究竟在发生些什么。
这个时候北大跑过来说商量下团队赛Paraseis的任务分配。case1和2是比较小的,北大主动说自己跑case3,山西大学说自己正在跑case2,我本来想的是鸭大来跑case4,鸭大不愿意,所以给鸭大分配了case1。FAU的集群crash掉了(大概率是中国大陆特供版L20和标准NVIDIA驱动水土不服的问题),所以给外国友人分配的任务是any case they want after their cluster restarts. 没办法,只能自己跑case4了。所以就拿出一个节点挂上了case4。
回来之后发现TCP timeout,报错信息里面的URL是huggingface的官网,但是ASC组委会魔改了lm_evaluate之后应该写死了,所以设置的hf_mirror没法用。花了一个小时摸索怎么给服务器配置通向国际互联网的大门,然后才把数据集下载下来。(山西大学对我们一开始没有给集群配置代理表示非常震惊,觉得访问国际互联网是理所应当的事情)
OOM。问了一下山西大学,需要75GB的显存才能跑出来。他们刚好是单卡80GB,就跑起来了。所以我就开始继续魔改脚本,在vllm上加进去tensor parallel。结果符合预期,很慢(vllm的张量并行就是很慢,官方优化得也不行)。挂着慢慢跑。
因为组委会只允许我们同时只有1台服务器联网,所以我们又在221上重复了一遍上面的操作跑case2。
但是case3给的正确性验证脚本又是可以识别GPTQ的,不知道lm_evaluate库封装的时候出了什么差错,所以跑完case2之后就开始跑GPTQ的正确性验证。
坑就是在这个地方,我们用awq跑的case1和2,但是是用gptq跑的结果准确性验证,是不足以证明我们的优化方案是合理的(所以结果正确性验证被扣了)。后知后觉,很遗憾。大约一个小时多之后,正确性验证跑完了,反正输出了一堆我看不懂的东西,而且始终觉得很奇葩的是明明是一个中文语料训练出来的模型,正确性验证打开的prompt一堆英文,实属抽象。
团队赛
因为在ASC22-23上还是认识了不少人,所以团队赛国内的四所高校还是很容易就联系上了,在团队赛发出来的时候就建了一个微信群。FAU怎么联系是个问题,好在ASC官方给每个队都提供了一份超级团队中各学校队长和指导老师的联系方式,于是给FAU的队长发了封邮件。然后微信群就陷入了长久的沉默(经典)。
然后就是等待戈多。ASC要求在3月29日之前上报各超级团队的队长和联系方式。在3月27号的时候,FAU还是杳无音讯,我们都怀疑是不是我们的邮件直接进了FAU队长的垃圾箱,所以又给FAU的指导老师发了一封。这次回得很快了,一天之后FAU就顺利进群。在群内其他高校的大力推荐下,本人很幸运(或者说不幸)地当上了D组的组长。
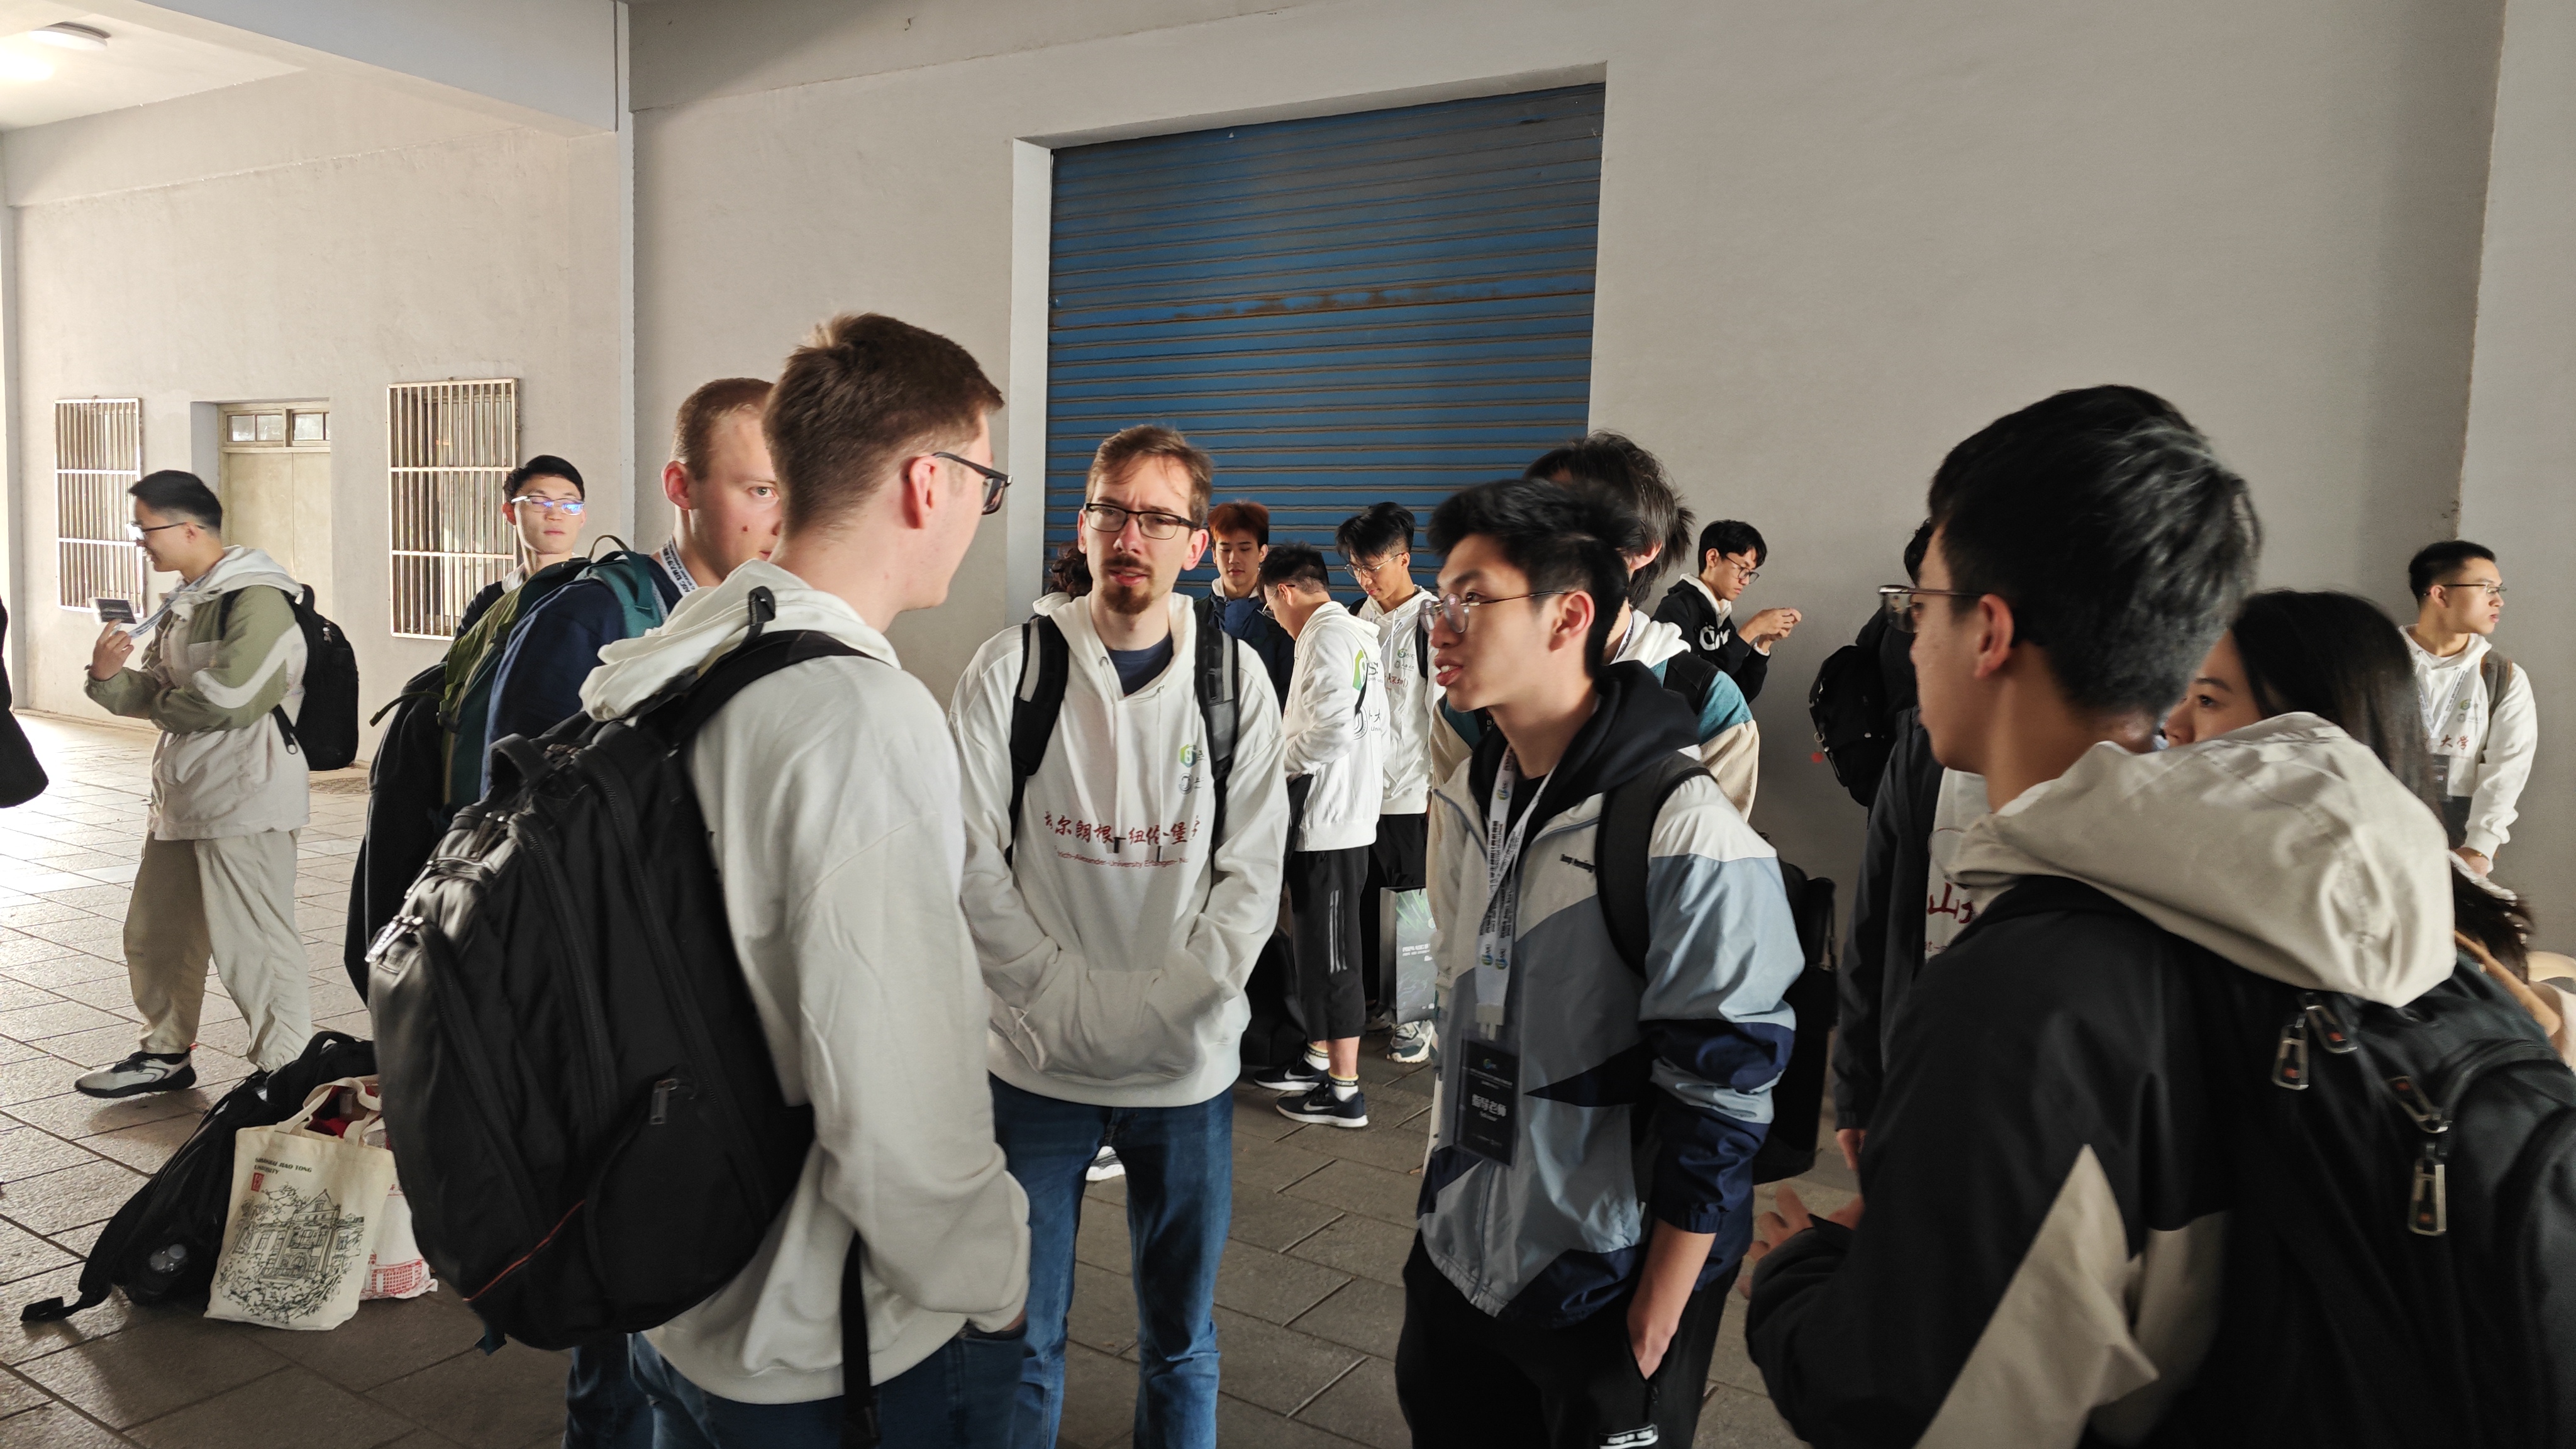
社牛黄瀚投完SC24之后来ASC疯狂social
得益于鸭大黄瀚的鼎力支持,提前帮我们把Paraseis这个不是汇编胜似汇编的应用踩好坑,我们编译起来都还算顺利。FAU也在群里跟我们互动,他们也装好了应用。之后北大孙远航又做了些其他的代码工作,让我们可以链接到Intel MKL的库,我们都确信有不错的性能提升。
最后北大和中山说自己功耗跑爆了,没跑出来。FAU很兴奋地过来拉着我说他们每个case都很快,尤其是case4,26分钟就跑完了。我看了一眼他们的输出,应该是代码没按着我们提供的版本改完,程序提前终止了,但看他们兴奋的样子,我也笑着说good job。我们的case4是全场唯一一个跑出来的,也得到了最高分;山西大学跑了case1和2,拿到了19分,但是可惜团队赛是几个队伍一起加起来,我们回天乏术,惜败给另一个大组。
今年的团队赛应用Paraseis很有经典科学计算程序的感觉(低情商:代码💩山),做的是地震波模拟,给的case是青藏高原地震带的地理情况。作为一个经历过大大小小地震的四川人,还是很有感触的。如果借助HPC的力量能够更好地模拟这些地震,那么更快的HPC就意味着我们能拯救更多的生命。
OpenCAEPoro、Gomars和Wannier
说实话,我没有想到过我可以编译出来神秘应用,毕竟去年就没编译出来。但是今年居然编译出来了,只是确实没有机时来跑了。
Day 1
计划表上整个上午都是OpenCAEPoro的。我们首先开始从最小的case跑起,发现一跑就会卡住在第一步上。在群里看见齐鲁工业大学的学生在怀疑case1有问题,我们倒是没管那么多,开始跑case2,然后跑完了case3。这个时候已经中午11点过了,我们预估了一下在下午一点半之前能够跑完,所以开始跑case5。下午一点半准时跑完。
这天中午还跟Jack Dogarra合了个照,也算是见到过了活的图灵奖(或者50w)。
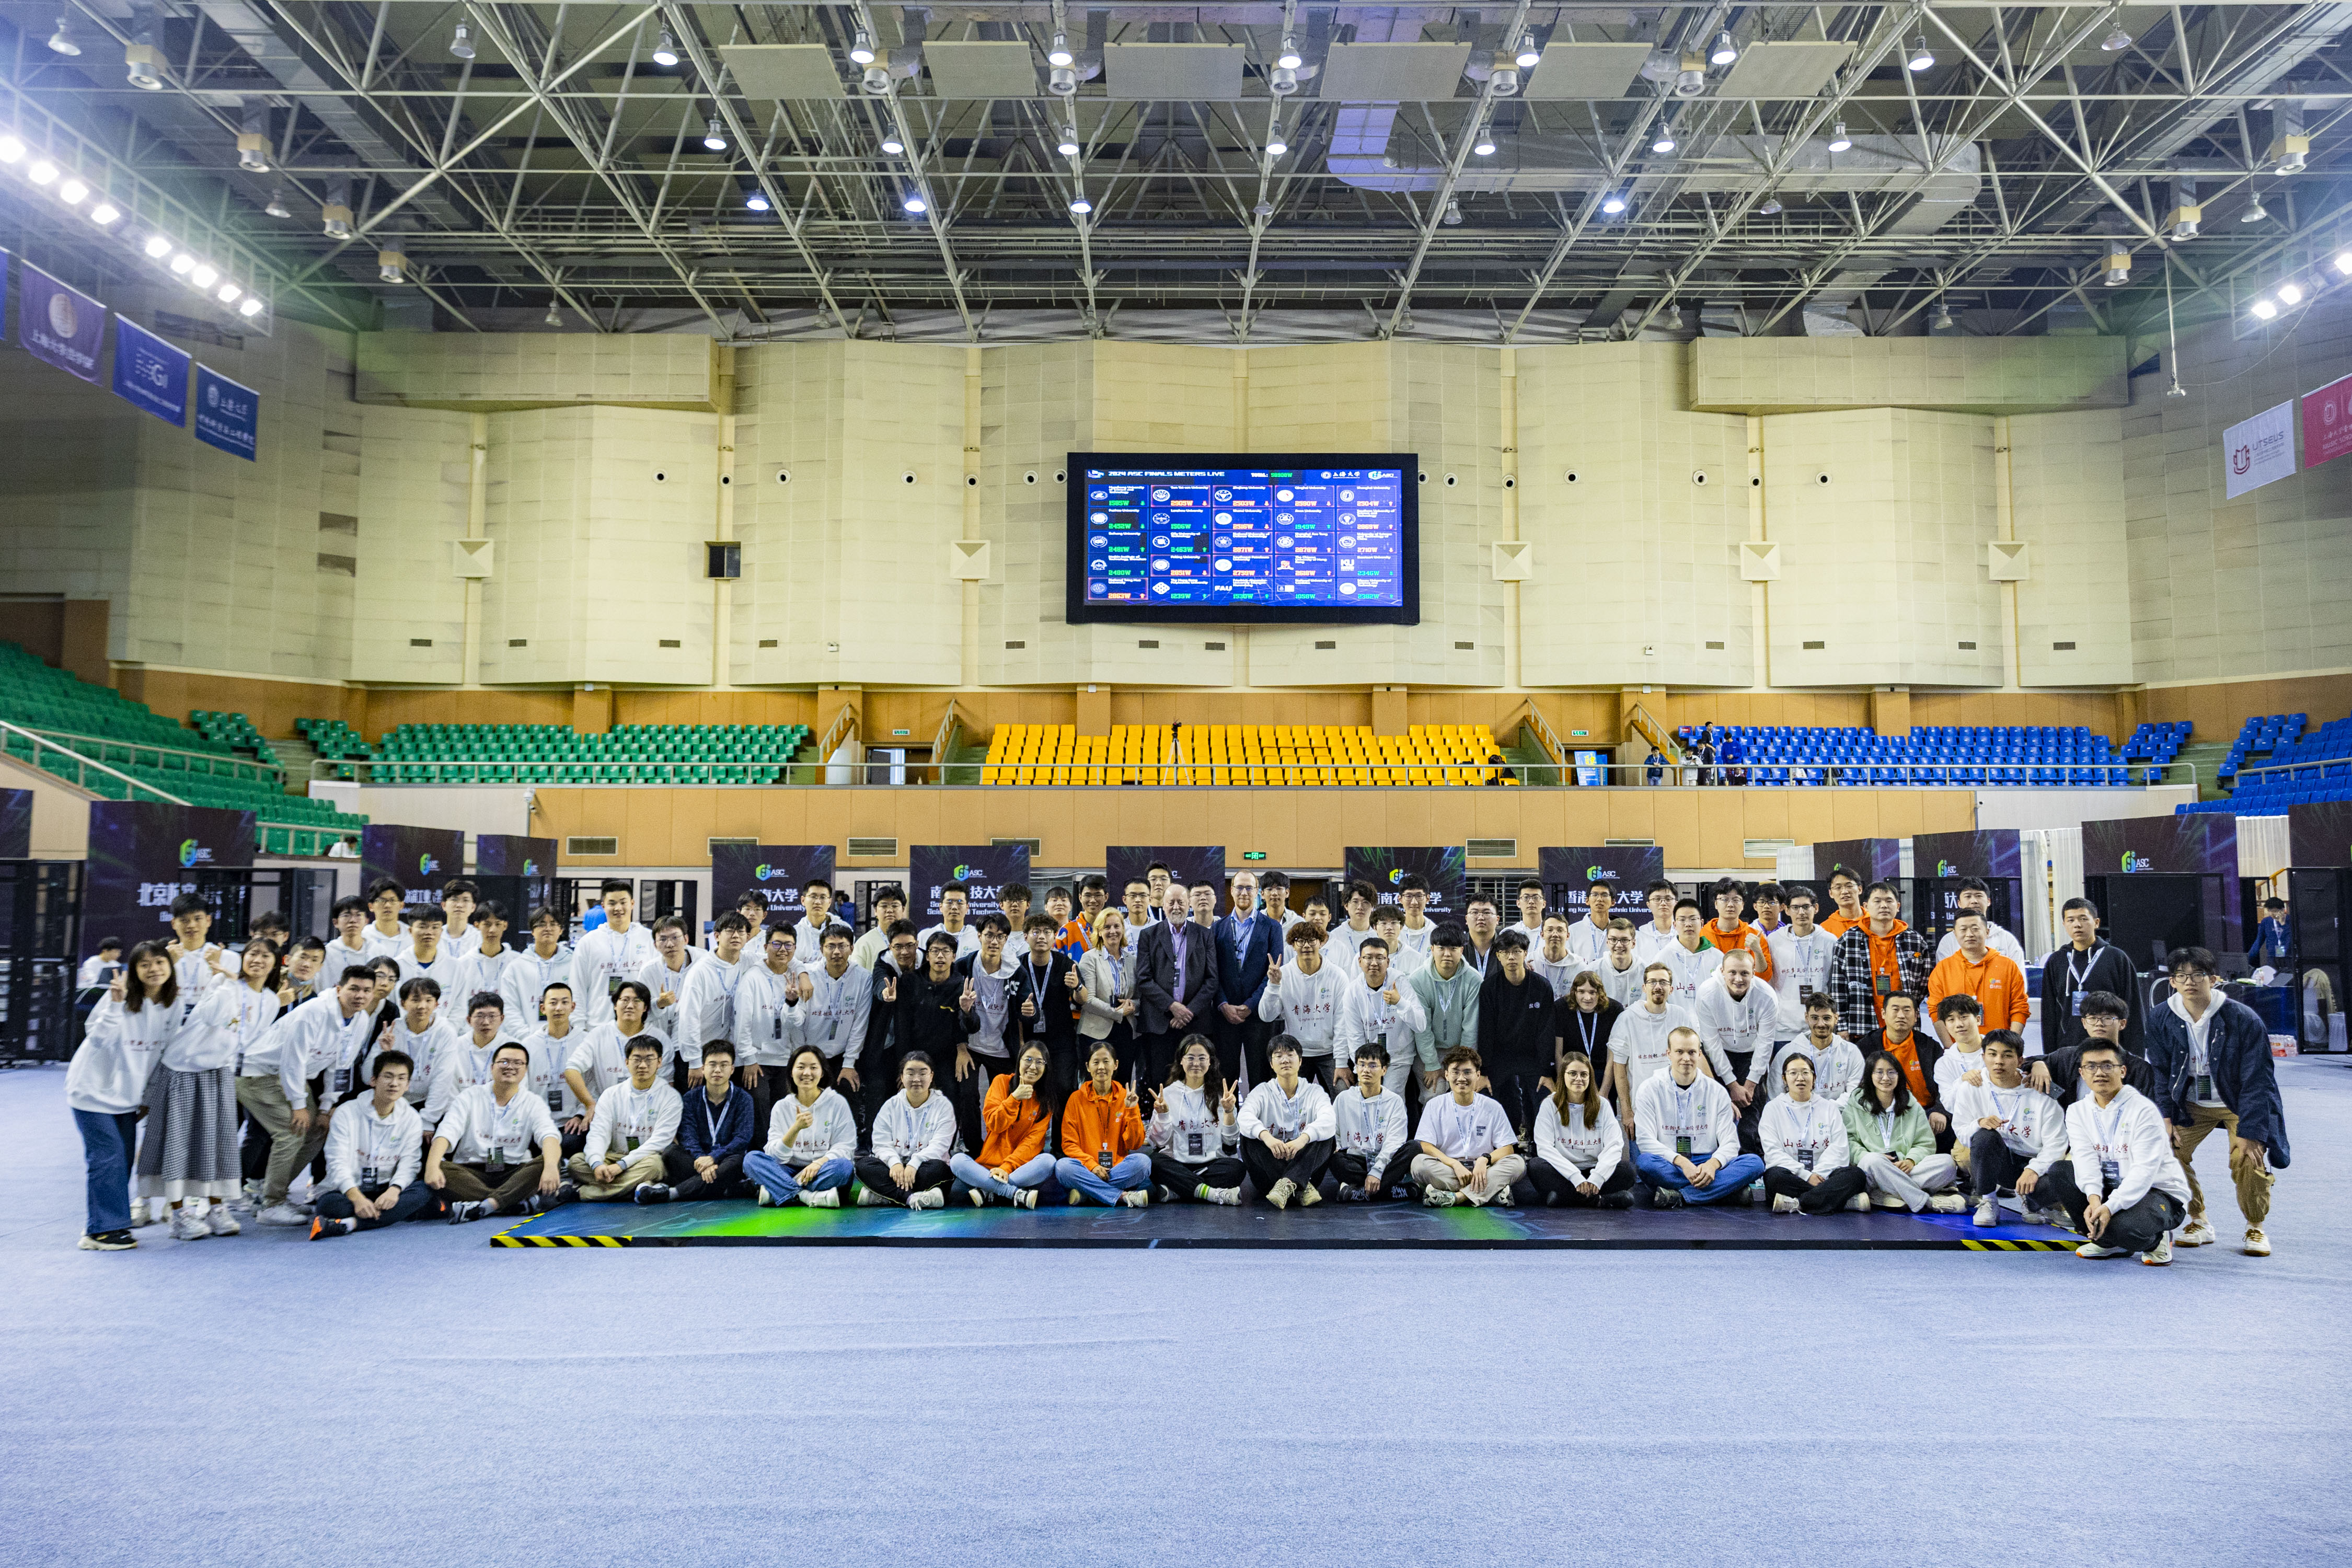
锐评一下:HPL已经不能引领时代潮流了,建议ASC以后换成HPL-AI
然后是Gomars时间。实际上我跟余骑在头一天晚上商量过了一个备用方案,但是比赛场上,高强度的环境下真的忘记了。余骑跟我迅速地在单机上跑完了case1和2,然后继续研究之前222炸掉导致的Permission denied Code 13问题。到下午两点时,我们又在222上重新编译了GMCORE,发现还是无效,这个时候我们试跑了case4,发现需要16小时。余骑在220上调参,我继续解决222上的问题,发现222上莫名其妙挂了一个nvc的进程,才知道Gomars之前为什么在222上严重掉速。把进程杀掉之后,CAE在齐鲁和山西大学的指导下使用221继续调试case1,这下是彻底没法并行了。
好在221上的CAE把case1跑出来了。但是这个时候已经下午三点半了。Gomars调参后余骑把运行时间从16小时降到了4小时,我们根本不可能跑完case3或者case4中的任意一个。但是我们还是继续尝试了集中参数组合,发现需要更多的进程数才能支撑Gomars在case3和case4上跑完。到四点钟的时候,我们评估了一下CAE在case4上的时间,预计我们大概在下午5:58能够跑完case4,马上清理出全部节点,开始全速运行CAE的case4。
case4可能是看在我们的窘迫境地上,跑了若干轮之后居然变快了,之前每一轮需要12秒,竟然奇迹般地变成了6秒。赌对了。最后我们在下午17:10左右跑完了case4,然后紧锣密鼓地完成了结果正确性验证。
事实证明,在2900瓦的功耗下跳舞还是很惊心动魄紧张刺激的。我们还对着机箱人力扇风(甚至带动了隔壁山西大学,组委会还专程跑过来拍照),真的可以节约数十瓦到一百瓦的散热功耗。最后结果正确性验证通过以后,我、余骑、熙涵、景愉都开心地跳了起来。
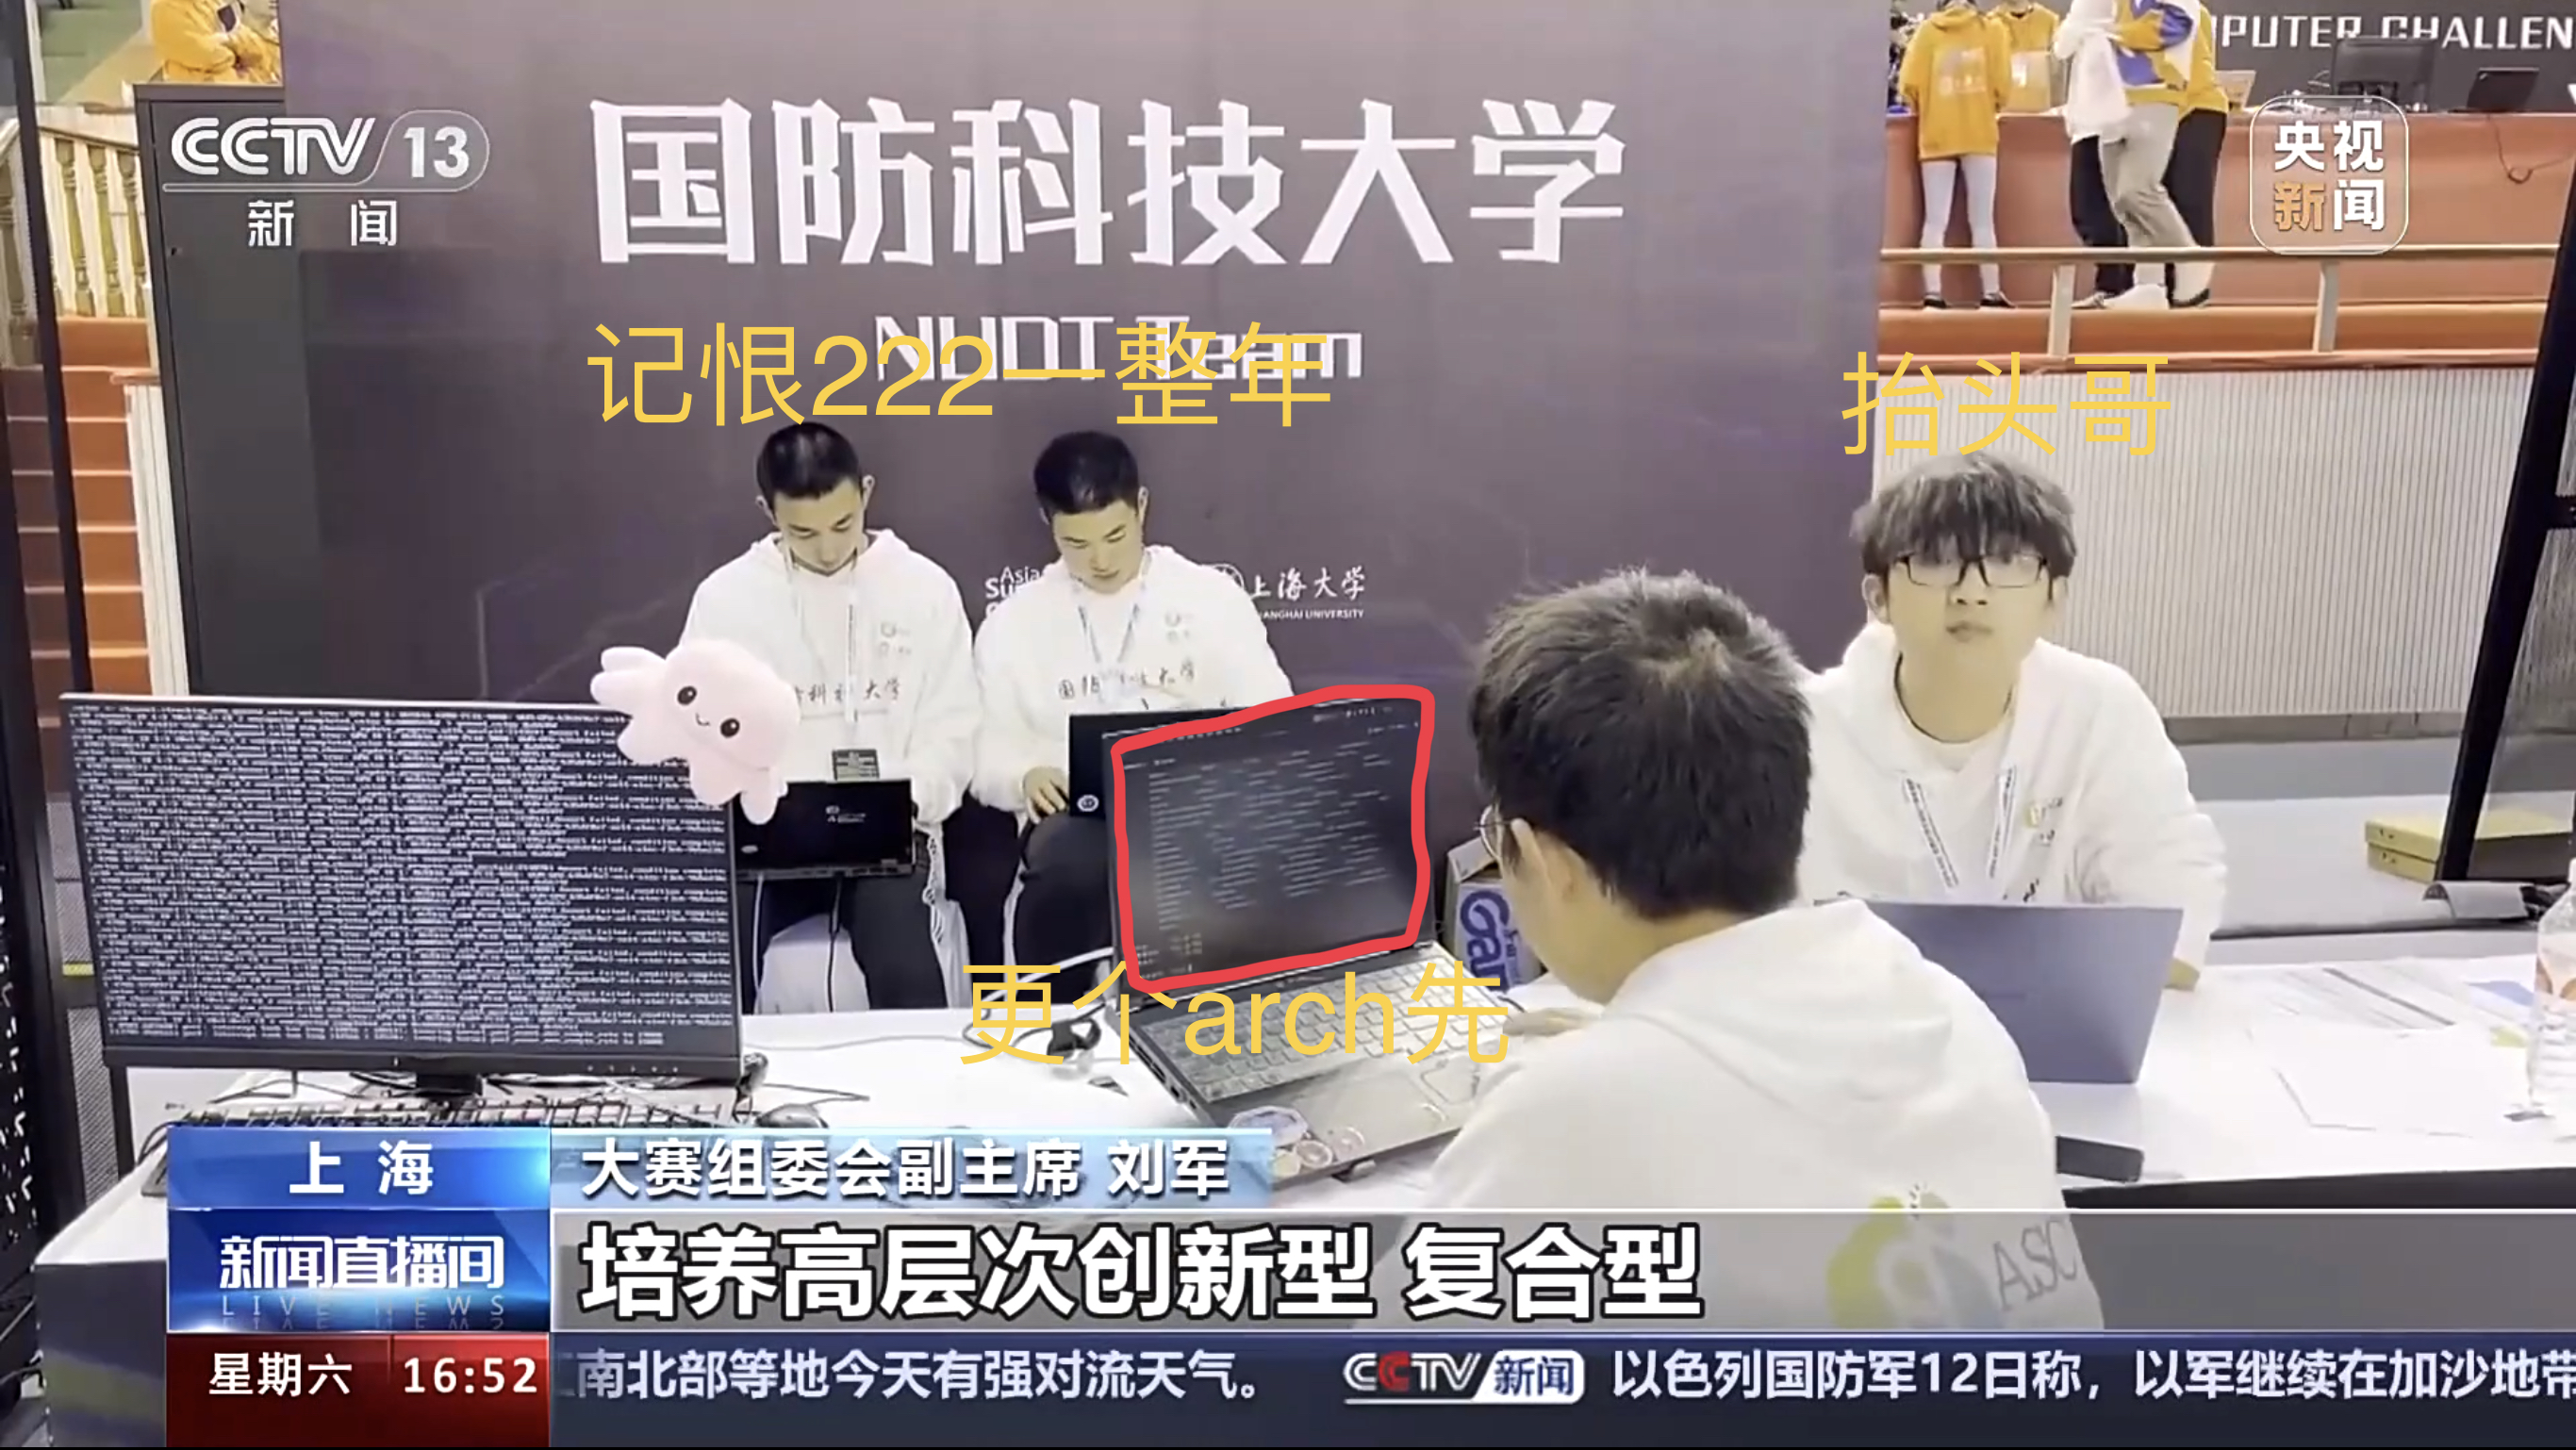
(景愉甚至在跑的时候给自己的Arch Linux升了个级😛)
北大蹭过来问我们怎么跑出来全部case的,笑而不语。
Presentation
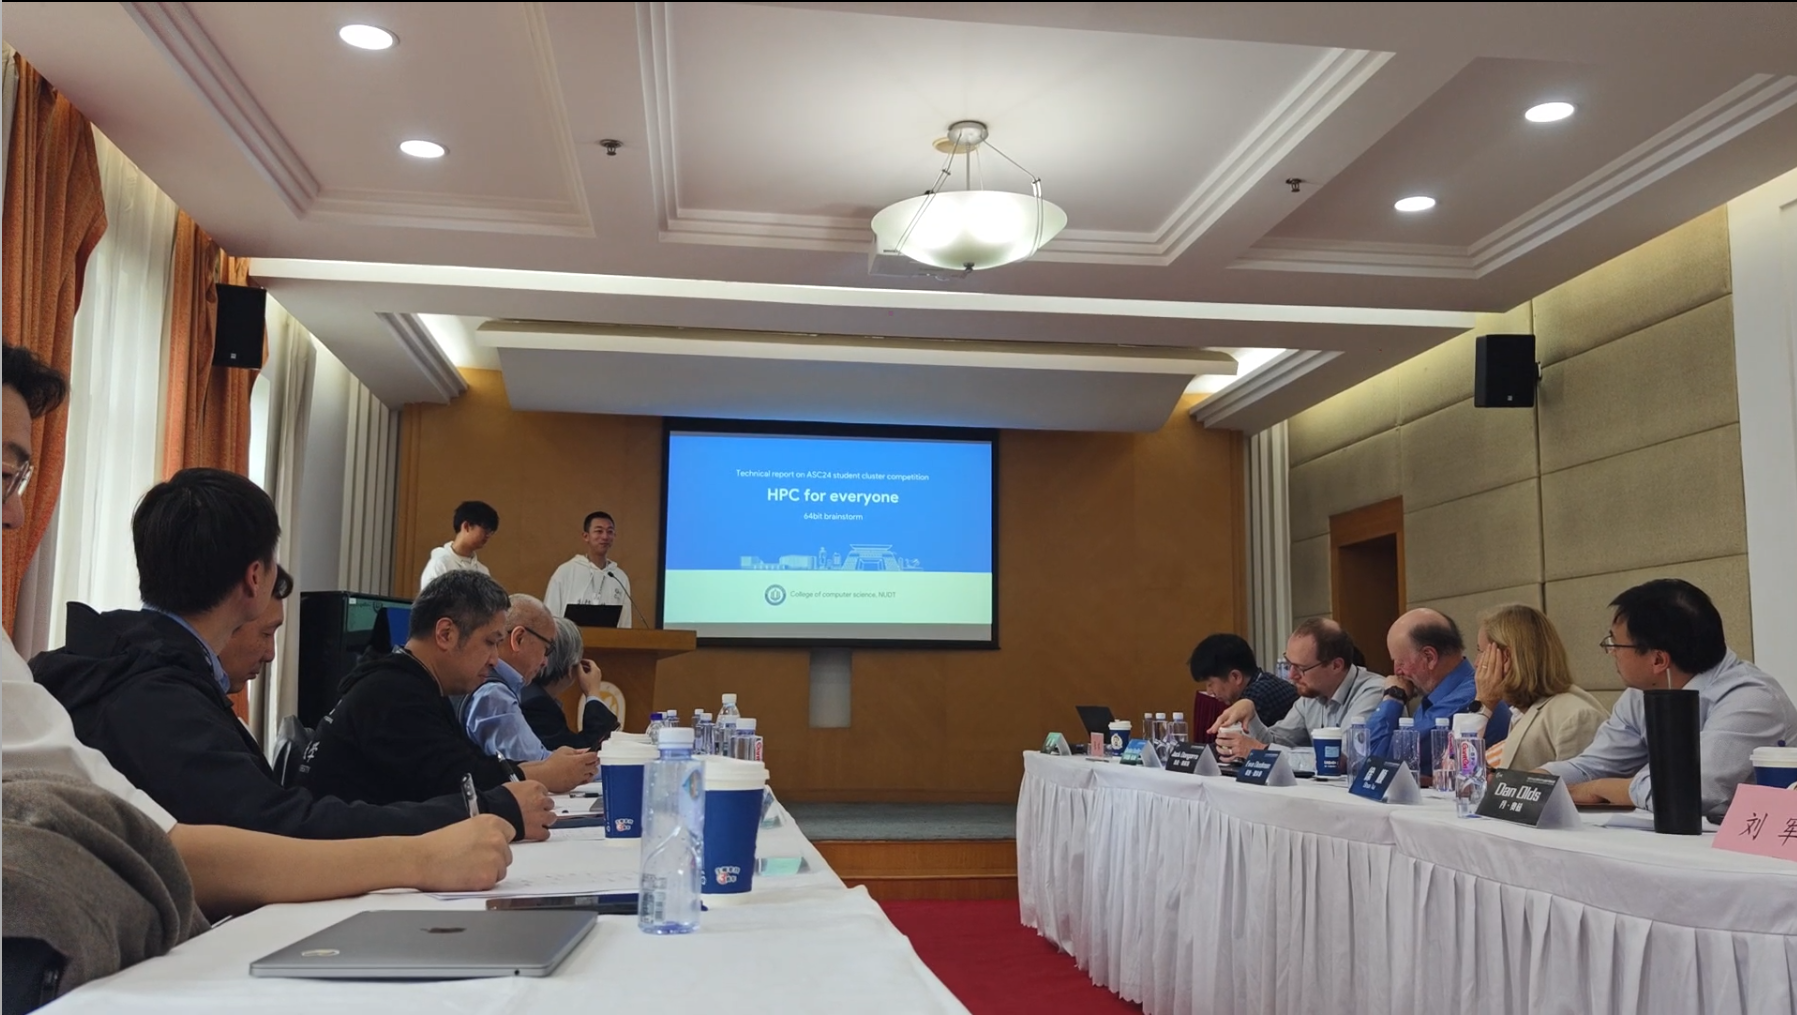
今年居然都到了答辩教室的门口候场了才告诉我们不能带稿子...还好最后答辩环节跟Torsten Hoefler谈笑风生。TH大佬应该对我的FP8 LLM非常感兴趣😎。
Dinner
社牛属性大爆发(可能是今年比得好了,不像去年唯唯诺诺),把上海大学领导、组委会和专家都敬了一圈。上海大学领导还问我们对上海大学什么感受,直接进行了一个真诚而华丽的吹捧。
袁国兴老师过来告诉我们我们学院做的机器好用,XX大学^[没进ASC24决赛]和某所做的机器不如我们,鼓励我们好好做机器,打破某国技术霸权。当然...他也说现在的天河做得不行...
大家都很喜欢我们,不论是组委会、专家还是其他学校的同学们。
很多时候对学校那是天天黑,但是对学院的感情是真的。成绩是真的干出来的不是吹出来的。
我们欠缺的
- 扎实的代码能力
- 比赛之外HPC/LUG/Geek的氛围
去年我写的是“对系统非常不熟悉”。今年我觉得,如果要想要有更长远的发展,在校园中(这里不仅仅是指课外,也包括了课内的课程、实验和讨论)培养学生Geek的氛围是推动学生能力成长最宝贵的资源。这样潜移默化的鼓励对学生的影响是深刻和长久的,正如《硅谷之火》里面说的那样
个人计算机的起源也颇具革命性,因为它并不是由那些搞研发的专业团队在成本昂贵、设备精良的实验室研制出来的。它始于企业和学术机构之外,由黑客、计算机发烧友和误打误撞的创业者利用业余时间在车库、地下室和卧室等地方创造出来...这些革命者用自己对这门技术的痴迷点燃了导火索。
Conclusion
这次遇到的队友很不错,和余骑、熙涵和景愉都能够一起很好地工作。我们最大的优点可能在于坚决和果断,说一机三卡就去做一机三卡,说四机八卡就立刻换四机八卡,说拆内存条就拆、说装就装。泓豪在场外也为我们做好了后勤保障,大家真的是卯足了劲,一起熬夜、一起一点一点地攻克难关。
不出意外地话,这也是我最后一次以参赛队员的身份参与到ASC的比赛中。是一段宝贵的、能够记住很长时间的经历。
祝大家顺利!